AI生图总翻车不是模型不行,是你prompt少了这三样
AI生图总翻车,你怪错了对象
"这模型不行,生成的图总是不对。"
你是不是也说过这句话?输入一段描述,点生成,出来的图要么主体不对、要么风格跑偏、要么光影奇怪、要么构图难看。反复试了十几次,还是不满意,最后得出结论:这个模型不行。
但真相是,90% 的翻车不是模型的问题,是你的 prompt 少了关键信息。
AI 生图模型就像一个能力很强但不会读心的设计师。你说"帮我画一只猫",它不知道你要的是橘猫还是英短、是写实还是卡通、是白天还是夜晚、是特写还是全景。它只能根据自己的"默认理解"来画,结果当然大概率不是你想要的。
一个对比
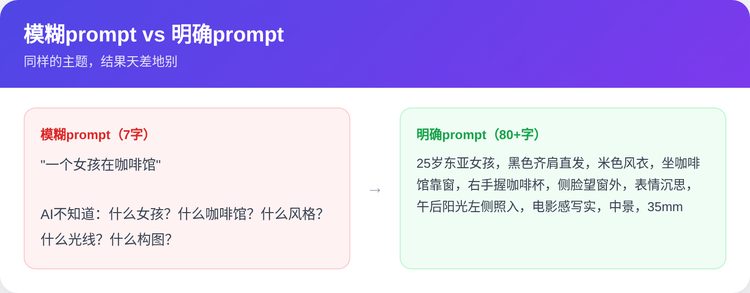
同样是画"一个女孩在咖啡馆",写"一个女孩在咖啡馆",生成的图可能是任何风格、任何角度、任何光线。但如果写"一个穿米色风衣的年轻女孩,坐在靠窗的咖啡馆位置,侧脸望向窗外,午后阳光从左侧照进来,在脸上形成柔和的光影,电影感写实风格,中景构图,35mm镜头"——出来的图和你脑子里想的几乎一模一样。
Seedream 5.0 Pro 的官方文档里,给出了让输出更稳定的五个核心要素。这篇就把这五要素拆解成小白也能直接用的填空式模板,照着写,翻车率至少降一半。
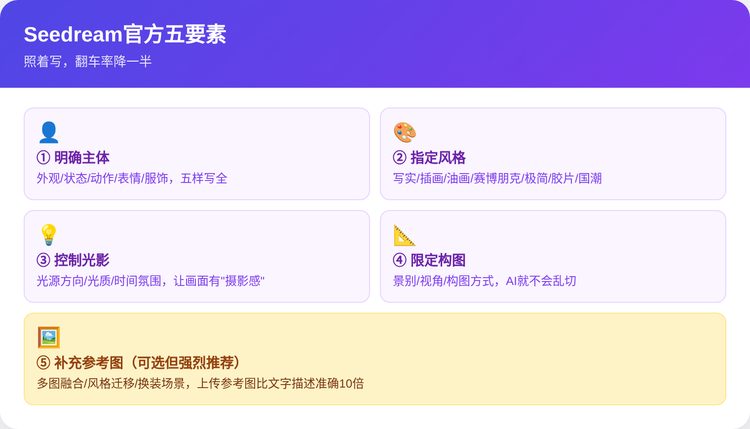
五要素一:明确主体
主体是画面的核心,也是最容易写模糊的地方。很多人写"一个女孩""一只猫""一杯咖啡",但 AI 不知道这个女孩长什么样、猫是什么品种、咖啡是什么杯子装的。
明确主体要写清楚五件事:外观(长什么样、什么颜色、什么材质)、状态(静止/运动、完整/局部)、动作(在做什么)、表情(开心/沉思/平静)、服饰(穿什么、什么风格)。
主体描述对比(点右上角图标即可复制)
❌ 模糊版:一个女孩在咖啡馆
✅ 明确版:一个25岁左右的东亚女孩,黑色齐肩直发,
穿米色宽松风衣,内搭白色T恤,坐在咖啡馆靠窗位置,
右手握着白色陶瓷咖啡杯,侧脸望向窗外,表情平静略带沉思,
桌上有一本打开的书和一副金属框眼镜
看到区别了吗?模糊版只有 7 个字,明确版有 80 多个字,但每一个字都在帮 AI 缩小"理解偏差"。你描述得越具体,AI 画出来的就越接近你想要的。
五要素二:指定风格
风格决定了画面的"气质"。同样一个主体,写实风格和赛博朋克风格画出来完全是两张图。
很多人不写风格,AI 就会用默认风格(通常是偏写实的通用风格),结果就是"好看但没特色"。指定风格要写清楚艺术方向(写实/插画/油画/水彩/赛博朋克/极简主义/胶片/国潮/日系等)。
Seedream 官方文档里还专门整理了风格词库,包括过度曝光、浪漫主义、商业广告摄影等方向。你可以在 prompt 里直接用这些风格词,AI 会自动匹配对应的视觉语言。
五要素三:控制光影
光影是画面的灵魂。同样的主体和风格,不同的光影会营造完全不同的氛围——正午阳光是明亮活力的,黄昏侧光是温暖治愈的,夜晚霓虹是神秘赛博的。
控制光影要写清楚三件事:光源方向(左侧/右侧/正面/逆光/顶光)、光质(硬光/柔光/自然光/人造光)、时间/氛围(黄金时刻/正午/夜晚霓虹/阴天漫射光)。
新手最容易忽略光影,但恰恰是光影让画面从"AI 生成感"变成"摄影师拍的"。写光影的时候,想象一下你是摄影师,你会在什么时间、什么地点、用什么光来拍这张照片,把这个想象写出来。
五要素四:限定构图
构图决定了"怎么看"这个主体。特写和全景传达的信息完全不同,俯拍和平视营造的感觉也天差地别。
限定构图要写清楚三件事:景别(特写/近景/中景/全景/远景)、视角(俯拍/仰拍/平视/低角度/鸟瞰)、构图方式(对称/对角线/三分法/居中/框架式)。
比如产品图常用"居中构图+中景+平视",人像特写常用"三分法构图+近景+平视",宏大场景常用"对称构图+全景+俯拍"。写清楚构图,AI 就不会乱切景别。
五要素五:补充参考图
文字描述再详细,也不如一张参考图直观。Seedream 5.0 Pro 支持多图参考,你可以上传参考图来指定风格、构图、人物姿势、服装款式等。
尤其是多图融合、风格迁移、换装这些场景,上传参考图能大幅提升还原度。比如你想让人物穿某件衣服,直接上传衣服的参考图,比用文字描述"一件蓝色条纹衬衫"准确得多。
参考图不是必须的,但如果你对某个要素有明确的要求,用参考图比用文字描述更靠谱。
填空式prompt模板,照着填就行
把五要素组合起来,就是一个万能的填空式 prompt 模板。不管你想画什么,把方括号里的内容替换掉,就能生成一个稳定的 prompt。
万能填空式prompt模板(点右上角图标即可复制)
【主体】[年龄/性别/种族]的[人物/物体],[外观描述:发型/颜色/材质],
[服饰/道具],[动作/状态],[表情/情绪]
【场景】[在哪里],[环境细节描述]
【风格】[艺术风格:写实/插画/油画/赛博朋克/极简/胶片/国潮等]
【光影】[光源方向]的[光质],[时间/氛围:黄金时刻/正午/夜晚霓虹等]
【构图】[景别:特写/近景/中景/全景],[视角:平视/俯拍/仰拍],
[构图方式:三分法/对称/居中/对角线]
【参考】参考上传的图[编号]的[风格/姿势/服装/构图]
【画质】高细节,8K,专业摄影,[镜头:35mm/50mm/85mm]
这个模板看起来长,但实际填起来很快。每个要素写一两句就行,不用写得像写作文。关键是五个要素都要有,不要漏。
Seedream 5.0 Pro 擅长什么、不适合什么
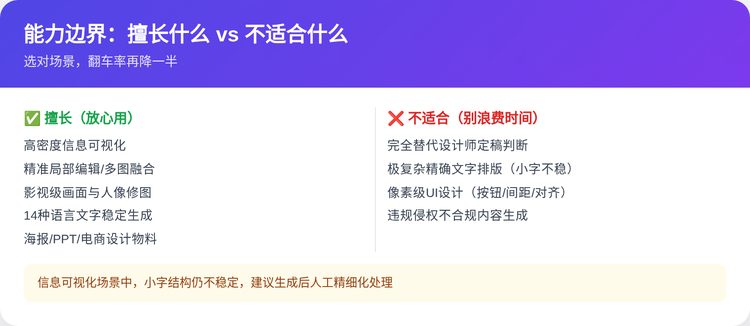
了解模型的能力边界,比盲目尝试更重要。Seedream 5.0 Pro 官方文档明确列出了擅长和不擅长的场景,照着选场景,翻车率再降一半。
擅长的场景(放心用)
· 高密度信息可视化:把数据、文字、知识点、概念、报告内容转化为视觉表达(信息图、知识卡片、数据海报)
· 精准局部编辑:通过图层分离和交互控制实现画面元素的精准编辑(换背景、改局部、多图融合)
· 影视级画面:高真实感、强叙事感的影视场景与人像修图
· 多语种文字:14 种语言文字的稳定生成,字符结构准确
· 设计生产:贴近实际业务场景的海报、PPT、品牌、电商等设计物料
· 多图融合:多张参考图中对象、风格、素材的统一融合
不适合的场景(别浪费时间)
· 完全替代专业设计师的最终定稿判断——AI 出初稿,人做最终决策
· 涉及精确文字排版的极复杂版式——小字结构仍存在不稳定问题,建议生成后人工精细化处理
· 需要精确到像素级控制的 UI 设计——按钮位置、间距、对齐这些需要精确控制的场景,还是用 Figma 等专业工具
· 生成违规、侵权或不合规的视觉内容——这个不用解释
三个实用技巧,让出图效率再提一档
1
复杂任务分步完成
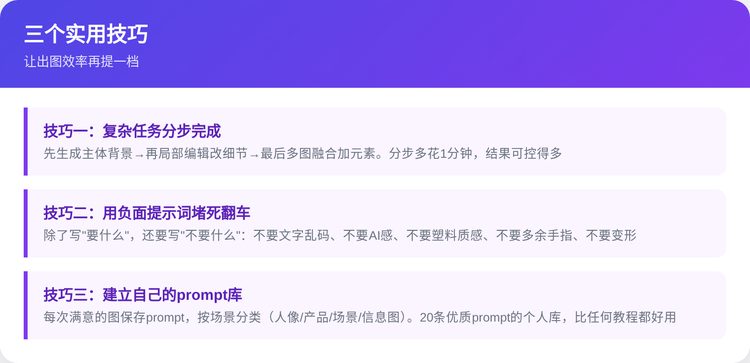
涉及多元素组合或精细编辑时,不要指望一次生成就完美。建议分步操作:先生成主体和背景,再用局部编辑改细节,最后用多图融合加元素。分步操作虽然多花一两分钟,但结果可控得多,而且每一步都能看到中间结果,出错好定位。
2
用负面提示词堵死翻车方向
除了写"要什么",还要写"不要什么"。常见的负面提示词包括:不要文字乱码、不要AI感、不要塑料质感、不要多余手指、不要变形、不要低分辨率、不要水印。把你不想要的东西列出来,AI 会主动避开这些方向。负面提示词放在 prompt 末尾,用"不要""避免"等词引导。
3
建立自己的prompt库
每次生成满意的图,把 prompt 保存下来,按场景分类(人像/产品/场景/信息图)。下次类似需求直接拿出来改主体和细节,不用从零开始写。一个积累了 20 条优质 prompt 的个人库,比任何教程都好用。
好的prompt,是和AI有效沟通的能力
很多人把 AI 生图当成"输入一句话,出一张图"的抽奖游戏,不满意就换个词再试,纯靠运气。
但真正高效的人,把它当成"和一个能力很强但不会读心的设计师沟通"的过程。你说得越清楚、越具体、越结构化,它交付的结果就越接近你想要的。
五要素(主体/风格/光影/构图/参考图)不是束缚,是沟通框架。它帮你把脑子里模糊的"我想要一张好看的图",拆解成 AI 能理解的具体指令。掌握了这个框架,你用任何 AI 生图工具都能比大多数人出图更稳、更快、更准。
下次生图,别再只写一句话了。用上面的填空模板,把五要素填全,试一次你就知道区别有多大。
作者声明:本作品含 AI 生成内容
2026-08-27 20:07:10
63 阅读
AI智能编辑WB
SeedreamAI生图prompt提示词AI绘画生图技巧
最新文章
即梦AI美食海报:248字提示词,一碗酸辣粉的国潮设计拆解
2026-09-11
即梦AI宠物海报:607字提示词,鱼眼镜头怎么拍出圆脸猫
2026-09-11
即梦AI美食海报:333字提示词,把「好吃」写成材质词
2026-09-11
即梦AI广告摄影:83字提示词,被437人抄了同款
2026-09-11
即梦AI食品海报:4层中文字怎么排?雪糕广告提示词全拆解
2026-09-11
即梦AI排版海报:中文字怎么排进画面?《荷花》提示词全拆解
2026-09-11
广西智慧万企传媒科技有限公司简称智慧万企,是一家为企业智慧经营全面赋能的营销科技公司。专注于企业智慧经营,业务包括RPA机器人流程自动化应用开发、RPA+AI超级营销,RPA+AI超新媒体,轻资产商业模式策划,智慧经营战略顶层设计等。
微信联系